看到的,就是模型真正的判断
唤醒模型好不好,最后都落在一个个具体的时刻:该醒的时候醒没醒,不该醒的时候有没有误醒。Kwscope 和训练时用的运行时逐帧对齐,屏幕上的每一次触发,都是模型上线后真的会做出的判断,不是近似。
项目速览
Kwscope 本身不带模型。开源权重的唤醒模型发布后,会在这里给出下载。
两级
一级听词,二级复核
逐帧
和训练侧的运行时对齐
0.2.0
当前版本 · MIT OR Apache-2.0
每一次醒来都有位置
1/3
绿色是收下的唤醒,红色虚线框是二级拦下的误报,上面的数字是二级的把握。下方是一级的分数曲线,越过黄色虚线的那一刻,模型醒了。
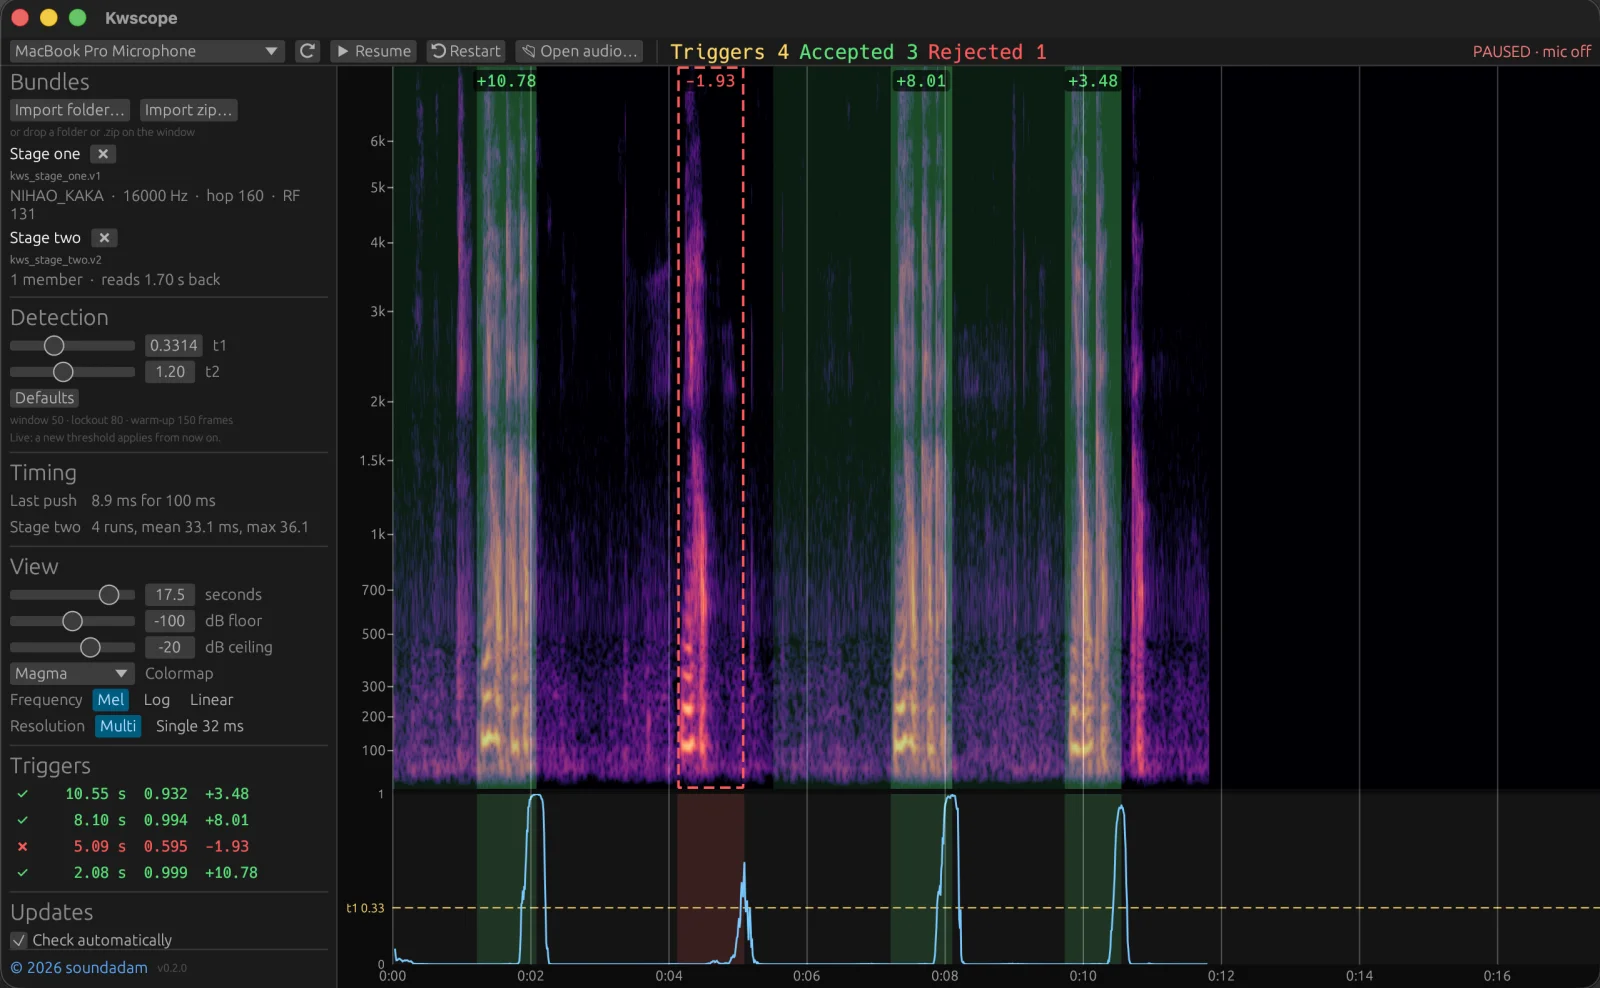
Kwscope 0.2.0 在 MacBook Pro 上接麦克风实测:四次触发,收下三次,二级拦下一次。
拖一下阈值,就知道该定在哪儿
2/3
唤醒永远在两种失败之间取舍:太灵敏会误醒,太迟钝会叫不应。拖动 t1、t2,打开的录音马上重判一遍,哪一次多出来、哪一次消失了,一眼就能看到。
在麦克风前,也在流水线里
3/3
最好的测试是自己开口说。接上麦克风,频谱随声音滚动,唤醒一出就标上。要成批跑录音时,用 kwscope stream,每个触发一行 JSON,直接接进评测。